Gridar
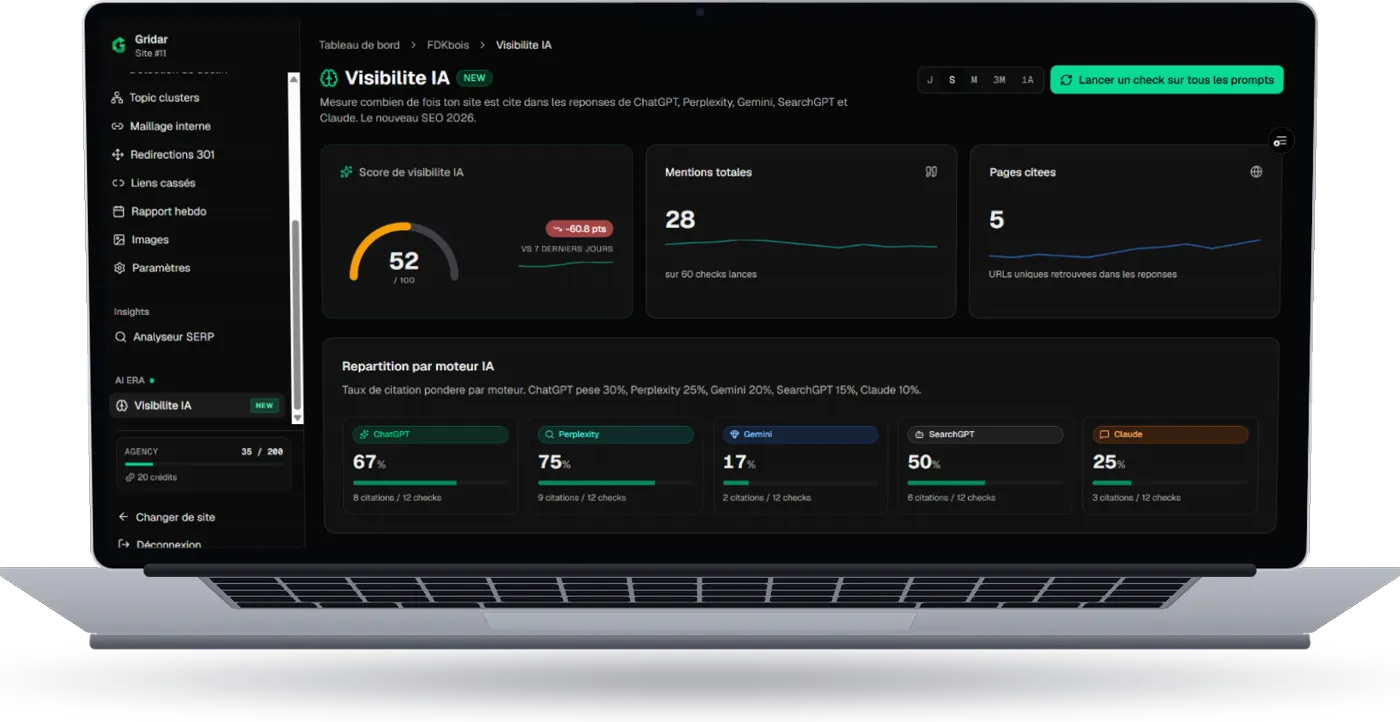
Audit SEO et mesure de la visibilite d'un site dans les reponses des IA. Produit personnel, en ligne sur gridar.app.
Technologies
A propos du projet
Gridar est mon SaaS de SEO automatisé, en ligne sur gridar.app. Il audite un site, suit les positions sur Google, détecte la cannibalisation entre articles, génère du contenu et mesure l'effet de chaque publication contre une baseline Search Console. C'est mon produit, pas un mandat client, et je le fais tourner en continu sur cinq sites que j'opère moi-même.
Le contexte
J'ai commencé en avril 2026 sous un nom descriptif, Blog Dashboard. Le 9 mai, après avoir empilé douze agents SEO, le multi-CMS, un serveur MCP, un node n8n, l'audit, le content decay et le graphe de liens, le nom ne décrivait plus rien de ce que le produit faisait. Je l'ai renommé Gridar.
La contrainte de départ : je suis seul dessus et je vise le Québec francophone, donc des PME qui ne parlent pas SEO. Ça élimine d'avance toute interface qui suppose qu'on sait lire un rapport de crawl. Le backend est en Django 5.2 avec DRF sur Railway, la base est un Postgres avec pgvector, le dashboard est en Vite, React 19 et TypeScript, le site marketing en Next.js 16. Claude fait la génération et l'audit, Voyage AI les embeddings, Serper les SERP.
Le problème
Pour utiliser Gridar, il fallait d'abord connecter son CMS : une App Password WordPress, une Custom App Shopify, des tokens Webflow, ou carrément un DATABASE_URL Postgres. C'était le point de décrochage principal du parcours d'inscription, et ça se comprend : je demandais un accès en écriture sur le site d'un inconnu avant de lui avoir montré quoi que ce soit. Et une bonne partie des PME que je visais n'avaient aucun blogue, donc ma réponse « active ton blogue » les faisait fermer l'onglet.
La cause réelle, je l'ai écrite le 15 mai 2026 : la value prop arrivait trop tard dans le funnel. Personne ne se lève le matin en se disant qu'il lui faut un générateur d'articles IA. Les gens se lèvent en se demandant si leur site marche sur Google.
Ce qui est venu ensuite était pire. Gridar livrait beaucoup de moyens, douze agents, du RAG, un autopilote, et pas la moindre mesure de l'effet d'un article publié sur les positions du site. Un outil qui ne mesure pas son propre effet demande à l'utilisateur de le croire sur parole. C'est la faiblesse que j'ai décidé d'attaquer avant d'ajouter la moindre fonction.
Ce que j'ai construit
J'ai pivoté le positionnement vers l'audit SEO au niveau du site : l'audit révèle le problème, la génération devient la suite logique, et le chemin d'entrée que j'ai retenu est une page d'audit publique sans compte requis. Environ 80 % du data layer existait déjà, intégration Search Console, suivi de positions, analyse SERP, PageSpeed, content decay. Ce qui manquait, c'était l'interface unifiée au niveau du site et le score composite, celui qui résume l'état d'un domaine en un chiffre qu'un dirigeant de PME peut lire sans formation.
Ensuite j'ai codé la boucle de preuve. À la connexion de Search Console, un signal capture une baseline des trente derniers articles : requêtes, positions, impressions et clics sur 28 jours. Un cron quotidien reprend chaque article publié à J+30, J+60 et J+90 et stocke l'écart contre cette baseline. Trois modèles, ArticleBaseline, ArticleAttribution et ProofShareToken, plus une page publique partageable derrière un jeton révocable. Le jeton est révocable par conception : une preuve de performance est une donnée d'entreprise, elle se partage sur décision de son propriétaire et elle doit pouvoir se retirer d'un clic.
Deux choix que j'assume. L'attribution est single-touch sur les données Search Console et pas multi-touch, parce que le multi-touch aurait été plus juste et jamais fini. Et les articles antérieurs à Gridar sont exclus par un drapeau, sinon je m'attribuerais du trafic que je n'ai pas produit. Une boucle de preuve qui se flatte elle-même ne vaut rien : le premier travail, c'est de l'empêcher de tricher en sa faveur.
J'ai aussi exposé le produit en serveur MCP, 43 outils, ce qui permet de piloter le SEO depuis un agent au lieu d'un tableau de bord. Fin mai, une erreur d'intégrité sur published_at a fait tomber l'ordonnanceur maison. J'avais le choix entre maintenir deux chemins d'exécution en parallèle ou n'en garder qu'un seul ; j'ai gardé le MCP, déjà le mieux couvert des deux. Depuis le 6 juin, toute la cadence passe par là : génération quotidienne à 7 h, audit hebdomadaire le dimanche, publication automatique seulement si le score d'audit dépasse 70, et aucune suppression d'article sans mon accord explicite. Ces deux derniers garde-fous ne sont pas négociables dans mon usage : une automatisation autorisée à supprimer du contenu sans validation humaine peut effacer des années de référencement en une nuit.
Le résultat
Au 19 août 2026, Gridar est en ligne sur gridar.app et pilote en continu le SEO de cinq sites qui m'appartiennent ou que j'opère. Je le fais tourner d'abord sur mes propres actifs, et c'est voulu : les pannes, les doublons et les positions qui glissent, je les prends dans la figure avant qui que ce soit d'autre. Un outil de SEO qui ne se mesure pas lui-même vend une méthode qu'il n'applique pas.
Le résultat dont je suis le plus content est un mauvais chiffre. Le 9 août, le rapport hebdomadaire a détecté 30 paires en cannibalisation sur gridar.app, dont trois quasi-doublons à plus de 90 % de similarité. Mon propre générateur réécrivait les mêmes sujets. En croisant les dates de publication, la cause est apparue mécanique : l'anti-doublon du pipeline vérifiait si un article avait déjà été généré dans la journée, jamais si le sujet avait déjà été couvert, donc avec une liste de mots-clés finie, juillet rejouait le calendrier de juin presque jour pour jour.
La réparation se fait par fusion et redirection 301, onze fusions au total, et jamais par suppression sèche : une page supprimée sèchement emporte avec elle ses liens entrants et son historique. C'est la règle que j'applique aussi quand je nettoie le contenu d'un site client, parce qu'une purge est irréversible alors qu'une redirection se corrige.
Gridar mesure aussi tokamdarius.ca, ce site-ci, avec les données de Search Console. C'est de là que sort mon plan de contenu : les pages à renforcer, celles à fusionner, les intentions de recherche encore absentes. Faire tourner l'outil sur le site qui le présente, c'est la seule façon honnête de savoir ce qu'il vaut.
Ce que la boucle de preuve produit, c'est une trace : pour chaque article publié depuis l'installation, l'écart de position et d'impressions contre la baseline du site à J+30, J+60 et J+90, partageable par lien. C'est la seule forme de rapport SEO qui m'intéresse, parce qu'elle se vérifie dans la Search Console du propriétaire du site plutôt que dans mon tableau de bord.
Ce que j'en retiens
Le 7 août, j'ai fait passer à mon propre auditeur un brouillon que j'avais volontairement rempli de chiffres fabriqués par le générateur, des montants et des pourcentages qui ne renvoyaient à rien. Il a rendu un bon score et repris ces chiffres comme des preuves d'expérience vécue.
C'est la leçon centrale de ce produit : un score d'audit note la forme, pas la vérité. Il mesure la structure, les balises, la densité, la lisibilité, et il n'a aucun moyen de savoir si le chiffre cité existe quelque part. Un modèle de langage produit une phrase plausible, pas une phrase vérifiée, et un second modèle chargé de la noter reste dans le même registre, il évalue lui aussi la plausibilité.
La conséquence est une règle de conception, pas un rattrapage : la vérification factuelle est une étape distincte de la génération, et elle est humaine. Aucun chiffre ne part sur un de mes sites sans que quelqu'un ait ouvert la source. Je le dis clairement à qui envisage d'automatiser son contenu : l'automatisation fait tomber le coût de production et le coût de structure, elle ne fait pas tomber la responsabilité de ce qui est affirmé. Une affirmation chiffrée publiée sous la raison sociale de quelqu'un l'engage, lui, et c'est exactement ce que je refuse de laisser décider par un modèle.
Deuxième leçon, du même genre. Un outil qui génère vite génère vite du doublon. Sans garde-fou anti-cannibalisation branché sur le sujet et pas sur la date, le volume finit par se manger lui-même, et le site perd des positions en publiant davantage. Le contrôle qui compte n'est pas de savoir si j'ai déjà écrit quelque chose aujourd'hui, c'est de savoir si j'ai déjà couvert cette intention de recherche.
Troisième, sur l'architecture d'exploitation. Deux ordonnanceurs qui font le même travail, c'est deux fois la surface de panne pour aucun gain. Quand il a fallu trancher, garder le chemin le mieux couvert et retirer l'autre a coûté moins cher que d'entretenir les deux.