Publiar - Automatisation de contenu
Plateforme SaaS qui permet de publier du contenu chaque jour sans y passer des heures. Automatisation de la creation et diffusion de contenu.
Technologies
A propos du projet
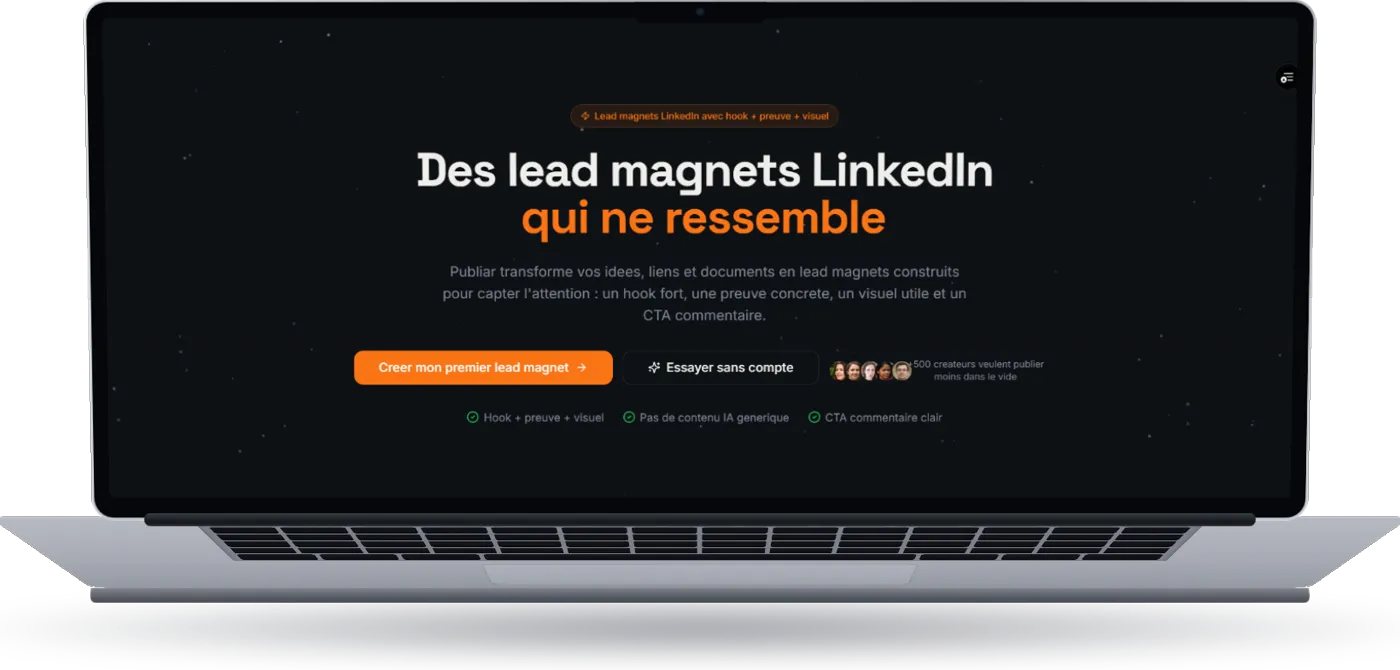
Publiar, c'est mon produit d'automatisation de contenu LinkedIn : un moteur qui transforme une idée en lead magnet avec un hook, une preuve et un visuel, adossé à un RAG qui apprend des posts déjà publiés par l'utilisateur. Il est en ligne sur publiar.app et distribué aussi comme connecteur MCP. Le moteur fait ce qu'il annonce. La partie que je n'ai pas construite, c'est le canal, et c'est de ça que parle cette page.
Le contexte
La première version était un couteau suisse : six zones plateformes, six « consultants IA », un carousel builder, des infographies, un autopilot, un calendrier, des templates, une base de connaissances, du TTS/STT, du repurposing, des analytics. En clair, un clone des outils déjà installés avec une couche IA par-dessus. Je l'ai tuée le 27 mai 2026. Le verdict d'audit tenait en trois points : pas de moat défendable, une profondeur fonctionnelle sans commune mesure avec le canal de distribution, qui n'existait pas, et un pricing sans moment aha.
Le lendemain, j'ai recadré le projet en founder-led : un tier fondateur à 79 CAD par mois pendant trois mois, cinquante places, pour des solopreneurs tech et des freelances IT francophones actifs sur LinkedIn au Québec. J'ai chiffré ce bassin entre 3 000 et 5 000 personnes avant de fixer quoi que ce soit, parce qu'une offre qui vise cinquante places dans une niche qu'on n'a jamais comptée n'est pas une offre, c'est un souhait.
Le problème
Quelqu'un qui utilisait Publiar depuis trois mois obtenait exactement le même résultat que celui qui l'ouvrait le premier jour. Chaque génération repartait de zéro, la bio était reconstruite à chaque prompt, rien ne s'accumulait. Un outil qui ne se souvient de rien ne donne aucune raison de rester.
L'autre problème est plus dur à entendre : personne ne veut acheter un générateur de posts. Les gens veulent des impressions. Quand j'ai listé les peurs et les objections prévisibles, les trois qui revenaient étaient « je poste, mais personne ne voit », « les posts ressemblent à tous les posts IA » et « ChatGPT peut déjà faire ça ». Un outil de génération ne répond à aucune des trois.
Ce que j'ai construit
J'ai attaqué la mémoire avec un RAG par utilisateur, en réutilisant telle quelle une app Django de ma librairie de templates (rag_memory_pgvector), sur pgvector, avec Voyage AI en voyage-3.5-lite à 512 dimensions. Le tenant est le user Django, pas le compte LinkedIn, pour ne pas me bloquer le jour où j'ajoute une plateforme.
Chaque post publié est réindexé avec un score d'engagement :
score = [log(likes+1) + 2*log(comments+1) + log(views/baseline)*10] * exp(-days/60)
Le baseline est la médiane des vues de l'utilisateur, donc l'échelle se calibre toute seule d'un compte à l'autre. La demi-vie de 60 jours évite qu'un vieux carton fasse la loi.
Trois choix que j'assume, avec la raison derrière chacun :
- Pas de reward modeling. Le cold start est fatal sous un millier de posts par utilisateur. Le scoring RAG plus une extraction de patterns par Claude suffisent, et ça tient jusqu'à 50 000 users.
- Epsilon-greedy à 20 %. Une génération sur cinq ignore les règles apprises. Sans ça, le système converge sur ses propres patterns et plafonne.
- Anti-hallucination dur côté extraction : Claude doit citer un extrait verbatim pour chaque pattern qu'il prétend avoir trouvé, sinon le pattern saute.
Sur la mécanique d'essai, j'ai tranché contre un autopilot de 15 jours qui aurait publié à la place de l'utilisateur. Trois raisons : le scope d'écriture LinkedIn fait décrocher 40 à 60 % des gens à l'onboarding, LinkedIn détecte les patterns d'automation et c'est le compte du client qui saute, et un compte neuf n'a rien à apprendre donc l'autopilot aurait publié du générique pendant deux semaines sur le profil pro de quelqu'un. J'ai gardé une Shadow Week en lecture seule : audit des 30 derniers posts, drafts quotidiens, l'utilisateur appuie lui-même sur publier. Refuser une fonction qui met le compte d'un utilisateur en danger fait partie du travail, même quand elle ferait une meilleure démo.
Côté distribution du produit lui-même, j'ai empaqueté Publiar en connecteur MCP. publiar-mcp 0.1.2 est sur PyPI et au registre officiel MCP depuis le 12 août 2026, 19 outils, publié par OIDC depuis GitHub Actions sans aucun secret stocké. Ça m'a coûté trois versions brûlées, dont une qui plantait à l'import chez quiconque l'installait parce que j'avais laissé la dépendance mcp non bornée vers le haut. Le garde-fou qui en est sorti tourne maintenant en CI avant chaque publication : environnement vierge, installation du wheel construit, import, comptage des outils, démarrage du binaire, vérification du refus attendu quand la clé API manque.
Le résultat
Ce qui existe et fonctionne : le connecteur MCP en ligne avec ses 19 outils, un rendu visuel Python plus Gemini piloté par 8 archétypes qui sort un PNG 1080x1080 ou un GIF animé, un outil pour réécrire le hook d'un post déjà publié, et le RAG par utilisateur qui réindexe chaque publication avec son score.
Ce qui manque est une liste précise, et c'est elle qui explique la décision d'arrêter : le suivi de baseline à l'onboarding, l'attribution post par post à J+7, le tableau de bord de preuve partageable, l'export PDF de l'audit. Ces quatre briques sont celles qui transforment une promesse en résultat vérifiable par l'utilisateur lui-même, dans ses propres chiffres. Je les avais identifiées, je ne les ai pas construites, et c'est la leçon que j'ai transportée telle quelle sur Gridar : la brique de preuve se livre en même temps que le moteur, jamais après.
Le produit n'a pas été mis en marché. Je n'ai monté aucun canal d'acquisition, et le projet est gelé depuis. C'est une décision de répartition du temps : entre pousser un produit dont le canal restait à construire et servir des mandats, j'ai choisi les mandats.
Ce qui en sort continue de servir. L'app rag_memory_pgvector venait de ma librairie de templates et a été réutilisée ici sans modification, ce qui est la meilleure preuve qu'elle était bien découpée. Le garde-fou de publication qui en est sorti est le patron que j'applique maintenant à toute mise en ligne de paquet. Et la mécanique de scoring calibrée par utilisateur est réutilisable partout où il faut classer du contenu par performance relative plutôt qu'absolue.
Passé à la grille de Thiel, le diagnostic était déjà là. Côté technologie, le moteur tenait la route, mais il lui manquait le différenciateur qui aurait rendu la copie difficile : sans ça, on reste dans la même catégorie que tout le monde. Côté distribution, je n'avais rien monté, et c'est la case que j'avais le moins travaillée des deux.
Ce que j'en retiens
Le code n'a jamais été le problème. Un RAG qui apprend, un scoring calibré par utilisateur, un paquet publié proprement sur deux registres avec une CI qui vérifie qu'il démarre pour de vrai : tout ça marche. Ce qui manquait se jouait en amont du code. Quand un produit tourne et qu'il ne rencontre pas son public, le goulot n'est pas technique, il est dans le canal.
Le mécanisme, je le nomme maintenant clairement, parce que c'est ce qui permet de le contrer. Construire récompense tout de suite : une fonction qui marche est une victoire visible le jour même. Vendre récompense plus tard, et sans garantie. À effort égal, un développeur ira vers la récompense immédiate et il appellera ça du travail. C'en est, mais c'est le travail de la deuxième moitié du problème, jamais de la première.
La règle que j'applique depuis : vingt conversations avec des gens de la niche avant la première ligne de code, pas après. Sur un mandat, ça se traduit autrement mais c'est le même réflexe : avant de proposer une architecture, je veux savoir à qui le client vend, ce qu'il a déjà essayé et ce qui a marché. Un livrable technique qui saute cette partie-là produit exactement ce que Publiar a produit : un moteur qui fonctionne et un canal qui n'existe pas.